"보기 좋은 3D 모델보다 실제로 조립되고 작동해야"… 일리노이대, LLM 에이전트 설계 평가 벤치마크 'LMBuild' 공개
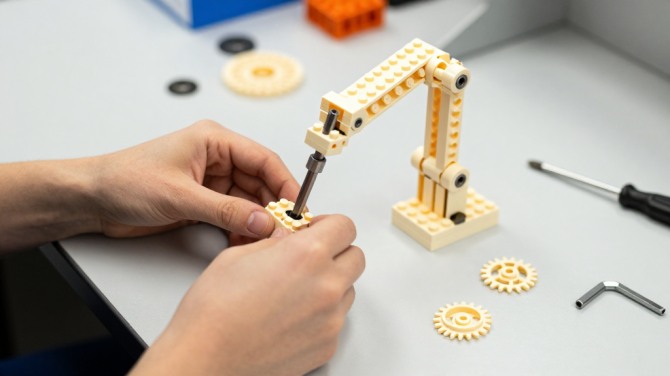
미국 일리노이대 어배너-섐페인(UIUC) 연구진이 대형언어모델(LLM) 기반 에이전트의 설계 능력을 평가하는 벤치마크 'LMBuild'를 내놨다. 실제로 조립할 수 있고 의도한 기능까지 하는 구조물을 설계하는지 보는 평가다. 지아텅 류(Jiateng Liu) 등 연구자 12명은 논문 사전공개 사이트 arXiv에 「LMBuild: Evaluating LLM Agents for Generating Buildable and Functional Structures」(arXiv:2610.04292)를 올렸다. 저자들이 공개한 초록에 따르면 30개 시스템을 평가한 결과, 최상위 비공개(클로즈드소스) 모델도 구조물이 제 기능을 하고 실제로 움직이게 만드는 데서는 여전히 어려움을 겪었다.
연구진이 이 벤치마크를 만든 이유는 기존 평가 방식의 공백이다. LLM 에이전트가 복잡한 3D 구조물을 만드는 능력은 빠르게 좋아지고 있고, 물건을 설계하고 현실에서 만드는 방식을 바꿀 잠재력도 크다. 하지만 연구진은 '보기 좋은 형상'을 만드는 일과 '실제로 만들 수 있고 제 기능을 하는 물체'를 만드는 일은 근본적으로 다르다고 지적했다. 지금까지의 평가는 주로 형상의 완성도만 보고, 그 물체를 실제로 구현할 수 있는지는 따지지 않았다는 것이다. 화면 속 의자가 그럴듯해 보여도 다리가 어떻게 붙는지, 어떤 재료로 어떤 순서로 조립하는지가 빠지면 실제 의자를 만들 수 없다는 문제의식이다.
LMBuild는 생성된 물체를 단순한 3D 형상이 아닌 '조립 구조물'로 다룬다. 물체를 부품 구성, 관절(조인트), 재료, 조립 순서로 나눠 표현하는 방식이다. 재현 가능한 평가를 위해 세 가지 요소를 하나의 프레임워크로 묶었다. 첫째는 에이전트가 도구를 써서 부품을 찾고, 새로 만들고, 배치하며 물체를 조립하는 상호작용 환경이다. 둘째는 기존 CAD 데이터셋을 평가용으로 다시 구성하고 위키피디아의 지식으로 보강한 벤치마크 데이터다. 셋째는 구조적 건전성, 기능적 어포던스, 디자인 품질, 물리적 구현 가능성을 따지는 평가 체계다. 어포던스는 물체가 사용자에게 어떤 동작을 허용하는지를 뜻하는 개념이다. 문이 경첩을 축으로 열리는지, 서랍이 앞뒤로 미끄러지는지 같은 성질이 여기에 해당한다.
30개 시스템을 평가한 결과 연구진은 세 가지를 확인했다. 먼저 최상위 비공개 모델에게 구조적 건전성과 지시 부합도는 더 이상 주된 걸림돌이 아니었다. 반면 기능적 어포던스와 물리적 작동 가능성은 훨씬 어려운 과제로 남았다. 형태를 갖추고 요구에 맞추는 수준은 넘어섰지만 '움직이고 쓸 수 있는 물건'을 만드는 단계에는 아직 이르지 못했다는 뜻이다. 다음으로 성능이 좋은 모델일수록 새 부품을 직접 만드는 데 능했고, 약한 모델은 기존 부품을 검색해 쓰는 쪽에 기댔다. 마지막으로 에이전트에게 기능 명세를 함께 주면 부품의 완결성, 운동학적 구조, 물리적 작동 가능성이 크게 좋아졌다.
연구진은 이 결과를 근거로 현실에서 쓸 구조물을 만들려면 기능적 어포던스와 역학에 대해 더 깊이 추론해야 하고, 새로운 부품을 설계하고 만들 줄도 알아야 한다고 결론지었다. LMBuild가 이 분야의 진전을 재는 기준이 되고, 조립 가능하고 기능하는 구조물을 만드는 에이전트 연구를 이끄는 토대가 되기를 기대한다고 밝혔다. 평가 대상 30개 시스템이 구체적으로 어떤 모델인지, 모델별 점수는 얼마인지는 초록에 나와 있지 않아 확인되지 않았다.
이 논문은 연구자 커뮤니티 플랫폼 허깅페이스의 일일 논문 목록에서 추천 20회를 받았다. 동료평가를 거치지 않은 사전공개 논문이다.